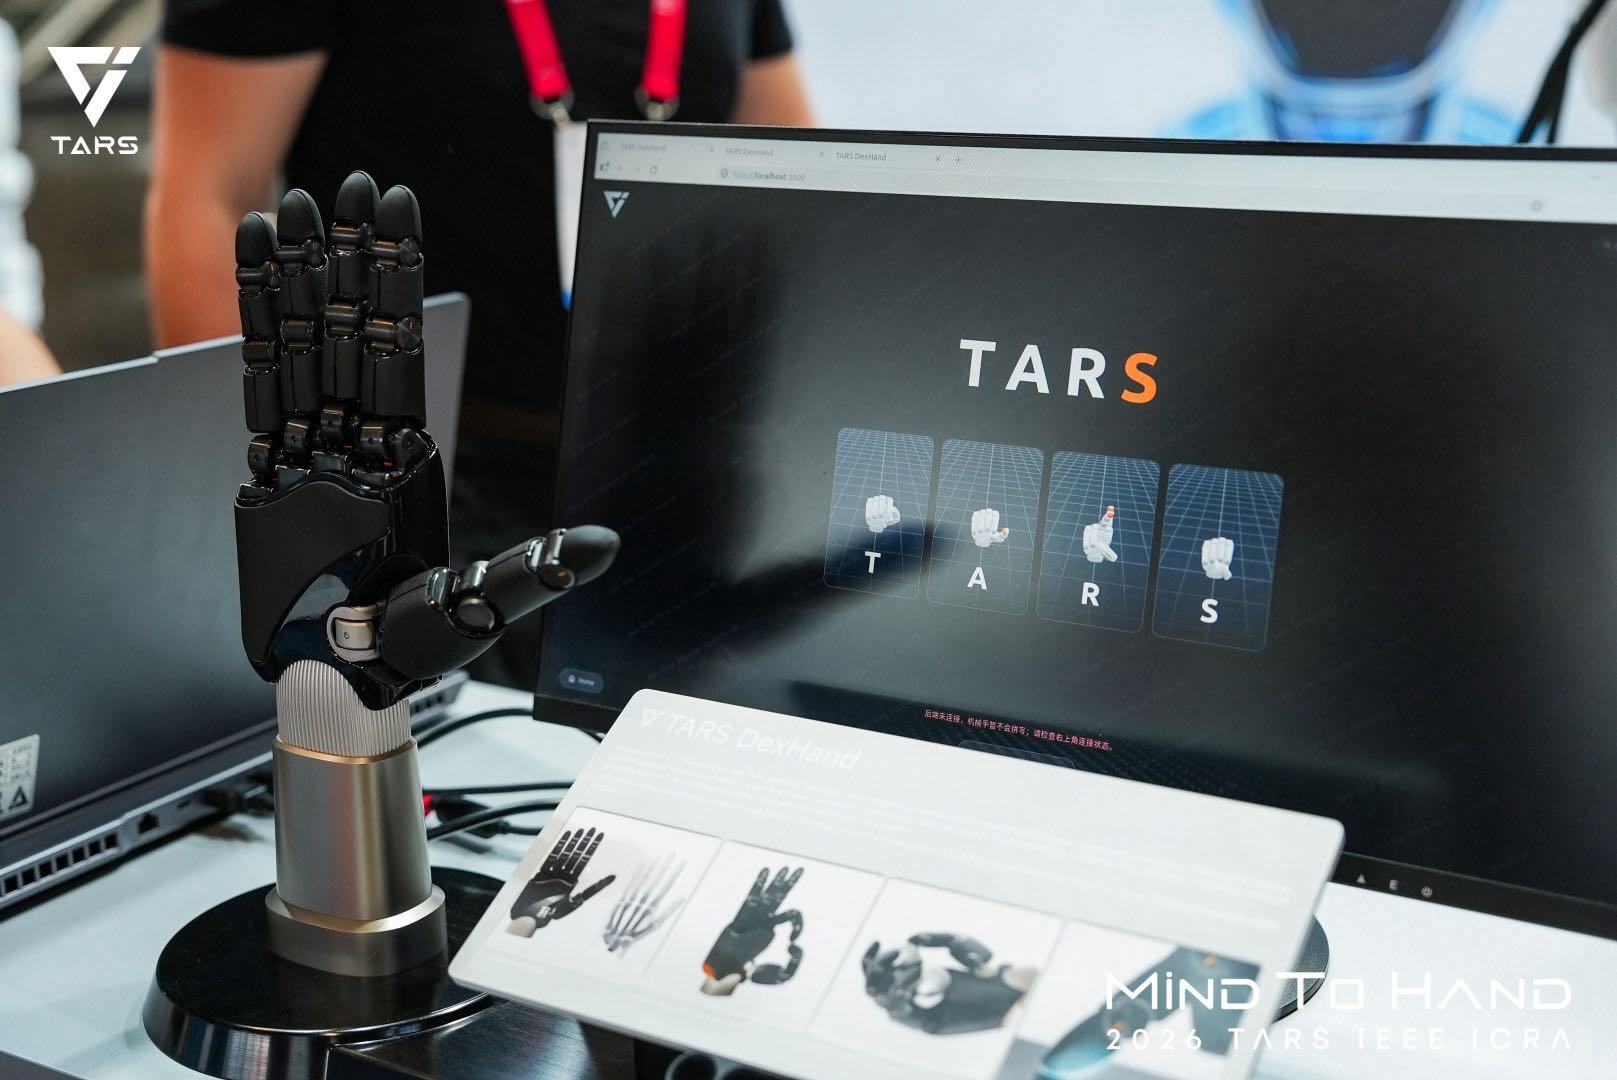
Für welche Anwendungsszenarien in der Praxis ist ein vollständiger Anthropomorphismus von Roboterhänden tatsächlich erforderlich?
Dr. Ding: Für Tars ist vollständiger Anthropomorphismus nicht die ideale Lösung für jedes Szenario. Uns geht es vielmehr darum, für jede Aufgabe die richtige Fähigkeit zu ermitteln. Bei hochpräzisen industriellen Aufgaben wie der Kabelbaummontage liegen die eigentlichen Herausforderungen in der Handhabung verformbarer Objekte, der Kontakterkennung, der Kraftsteuerung und der Ausführung über einen langen Zeithorizont hinweg. Für diese Art von Szenario kann ein spezieller Greifer eine effizientere, stabilere und skalierbarere Wahl für den Masseneinsatz sein. Die Kabelbaummontage zeigt, dass Physical AI echte physikalische Interaktionsprobleme lösen muss, aber das bedeutet nicht, dass jede Aufgabe eine menschenähnliche, geschickte Hand erfordert.
Vollständig anthropomorphe, geschickte Hände eignen sich besser für Szenarien, die ursprünglich für menschliche Hände konzipiert wurden und komplexe Fingerhaltungen sowie die Koordination mehrerer Finger erfordern. Beispiele hierfür sind die Verwendung menschlicher Werkzeuge, die Handhabung kleiner und komplexer Objekte, die Ausführung mehrstufiger Alltagsaufgaben, die Ermöglichung gestenbasierter Interaktion und schließlich der Einsatz in Haushalts-, Dienstleistungs- und bestimmten Präzisionsanwendungsszenarien.
Für uns geht es beim Anthropomorphismus nicht um das Aussehen. Es geht um Leistungsgrenzen und Datenabgleich. Wenn Roboter von echten menschlichen Handgriffen lernen und diese nachahmen müssen, lässt sich eine Hand in menschlicher Größe mit menschenähnlicher Kinematik besser an menschenzentrierte Daten anpassen und menschliche Handlungen natürlicher auf den Roboterkörper übertragen.
Wie viele Freiheitsgrade haben Sie mit Ihren aktuellen Prototypen erreicht, und warum gerade diese Zahl?
Die menschliche Hand verfügt über 21 Freiheitsgrade (plus sechs weitere in den Handgelenken), und die DexHand von Tars arbeitet mit 21 Freiheitsgraden, was weitgehend der natürlichen kinematischen Struktur der menschlichen Hand entspricht. Diese Zahl ist nicht willkürlich gewählt. Für unsere Designziele ist dies eine sinnvolle Schwelle, um natürliche Handbewegungen darzustellen und gleichzeitig unnötige Redundanz zu vermeiden. Für anspruchsvolle Robotikanwendungen entwickelt: Die drehbaren RQDR-Halter von FLEXA bieten eine platzsparende und robuste Kabelführung, die Cobots bei komplexen Bewegungsabläufen zuverlässig unterstützt. ‣ weiterlesen
Eine Überschreitung der 21 führt zu einem Problem, das oft übersehen wird: Datenfehlanpassung. Unsere gesamte Trainingspipeline basiert auf menschenzentrierten Daten – echte Menschen, die echte Aufgaben ausführen, erfasst durch unsere SenseHubHandschuh-Suite. Wenn die Roboterhand sechs oder sieben Finger hat oder Freiheitsgrade aufweist, für die es kein menschliches Äquivalent gibt, kann man keine passenden Trainingsdaten von einer Person erfassen. Man wird einen problematischen Retargeting-Prozess haben. Für unsere menschenzentrierte Trainingspipeline ist die Abstimmung der Kinematik der Roboterhand auf die Kinematik der menschlichen Hand wertvoller als das bloße Hinzufügen weiterer Freiheitsgrade. Daher gilt: Mehr ist nicht immer besser; Abstimmung ist besser.
Flexibler Kabelschutz für Cobots
Wie erreicht man taktiles Feedback mit hoher Dichte, ohne dass Datenvolumen und Latenz außer Kontrolle geraten?
Dies ist eine der am meisten unterschätzten technischen Herausforderungen in diesem Bereich. Unser Ansatz ist eher architektonischer Natur als rein Hardware orientiert. Wir versuchen nicht, jedes taktile Signal mit derselben Frequenz und Auflösung zu verarbeiten. Stattdessen nutzen wir eine mehrschichtige Erfassungsstrategie, die in unsere Tac-ForeSight-Technik integriert ist. Präzisionsgetriebe stellen hohe Anforderungen an Fertigung und Qualität. Liebherr bietet flexible Lösungen für die Herstellung von Zykloiden- und HarmonicDrive®-Verzahnungen – von der Prozessentwicklung bis zu Maschine, Schulung und Service. ‣ weiterlesen
Kraft- und Drehmomentsignale auf Handgelenkebene liefern uns zunächst das Gesamtbild – allgemeine Kontakttrends, Belastungsrichtung und Kraftstärke über die gesamte Hand hinweg. Diese Signale sind niedrig dimensional und lassen sich extrem schnell verarbeiten. Die taktilen Sensoren an den Fingerspitzen liefern dann hochauflösende lokale Daten, jedoch nur in den Kontaktzonen, die für die aktuelle Teilaufgabe aktiv relevant sind. Durch diese Priorisierung überfluten wir das System nicht mit undifferenzierten Daten hoher Dichte, sondern streamen strukturierte, kontextuell gefilterte Informationen.
Die tiefgreifendere Lösung ist jedoch unser AWE-3.0-Weltmodell, das im latenten Raum operiert. Anstatt auf jeden rohen Sensorwert zu reagieren, pflegt das Modell kontinuierlich eine komprimierte interne Darstellung der physischen Umgebung. Es sagt Kontaktzustände voraus, bevor sie vollständig eintreten, sodass das System bereits eine Reaktion vorbereitet, während sich das physische Ereignis noch entfaltet. Diese vorausschauende Pufferung sorgt dafür, dass die Latenz auch unter hochfrequenten Manipulationsbedingungen beherrschbar bleibt.
Verzahnung für die Robotik
Wie gestaltet man die Sensorfusion, um schnelle Reaktionen zu ermöglichen?
Die herkömmliche Annahme in der Branche war eine Dual-System-Architektur: ein langsames, hochrangiges Gehirn für das logische Denken und ein schnelles, niedrigrangiges Kleinhirn für die Ausführung, die parallel, aber weitgehend unabhängig voneinander laufen. Tars entschied sich von Anfang an für einen einheitlicheren Ansatz, und unsere Experimente haben diese Richtung bestätigt.
Unser Ansatz vereint alles in einer einzigen Modellarchitektur, wobei der Latenzraum als Brücke dient. Bilddaten, Kraft-/Drehmoment-Signale, taktile Daten und der Aufgabenkontext auf Sprachebene werden alle in eine gemeinsame latente Darstellung kodiert. Aktionsausgaben werden asynchron innerhalb dieses Latenzraums generiert, bevor sie in physikalische Befehle dekodiert werden. Das bedeutet, dass das Modell in einer komprimierten Welt, die schneller ist als die physikalische Zeit, effektiv vorausdenkt und anschließend Aktionen reibungslos in die Realität umsetzt.
In Tests hat diese Architektur eine deutlich schnellere Inferenz bei gleichbleibender Bewegungsflüssigkeit gezeigt. Die Latenz bei der Sensorfusion ist in erster Linie kein Hardwareproblem, sondern ein Problem der Modellarchitektur. Sobald man Wahrnehmung und Aktion nicht mehr als aufeinanderfolgende Pipeline-Schritte betrachtet, sondern als gemeinsam ablaufende Prozesse innerhalb einer einheitlichen Darstellung, löst sich das Latenzproblem weitgehend auf.